Проверил sitemap 26 крупных сайтов: в Google нет почти каждой пятой страницы карты
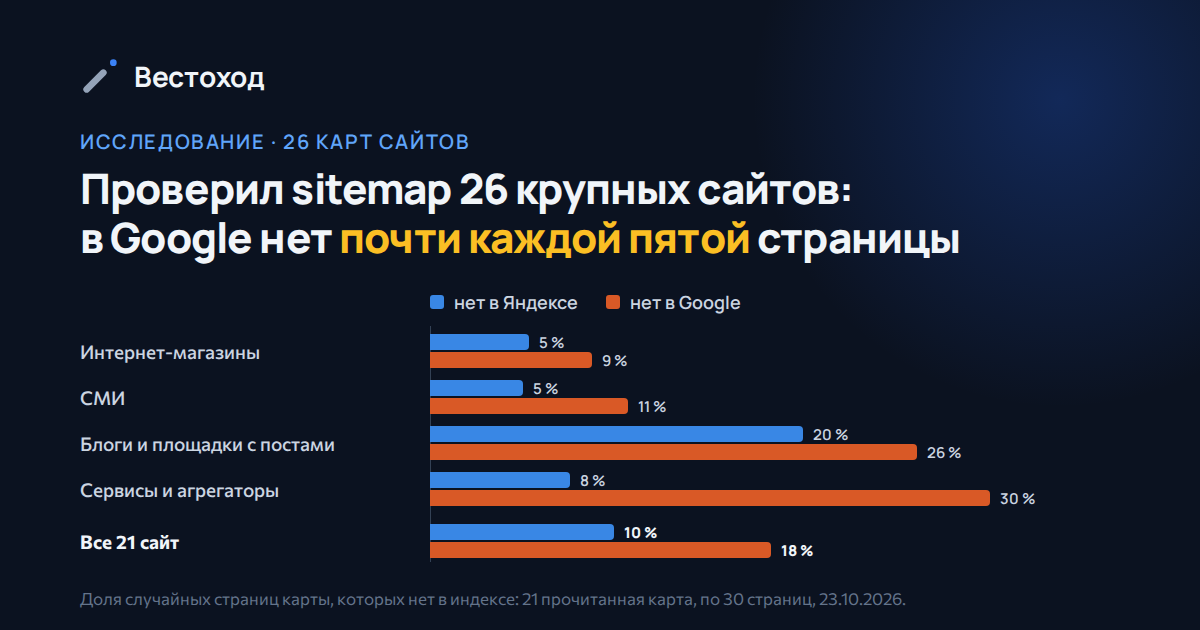
Карта сайта — это список страниц, которые сайт сам просит проиндексировать. Я взял карты 26 крупных российских сайтов — магазинов, СМИ, блогов и сервисов — и проверил случайные страницы из каждой: есть ли они в индексе Яндекса и Google и что они отвечают поисковому роботу. Яндекс не знал 10 % проверенных страниц, Google — 18 %, а у отдельных сайтов — до двух третей. Заодно выяснилось, что в картах лежат мёртвые страницы и редиректы, а треть сайтов не пустила чужого робота дальше порога.
Как проверял
- Сайты. 26 крупных сайтов в четырёх группах по 6–7: интернет-магазины, СМИ, блоги и площадки с пользовательскими постами, сервисы и агрегаторы. Названий не будет: меня интересует картина, а не разбор чужих сайтов.
- Карта. Там, где её объявляет сам сайт, — в строке
Sitemapфайла robots.txt, а если её там нет — по адресу/sitemap.xml. У больших сайтов карта — индекс из сотен файлов; я читал до 10 файлов и 50 000 адресов. Целиком прочиталась одна карта из 21, у остальных — первые файлы. - Выборка. 100 случайных страниц из прочитанного — именно случайных, а не первых: в начале карты обычно главная и разделы, самые здоровые страницы сайта. Каждую я запросил так, как запрашивает робот: код ответа, редиректы,
noindex, robots.txt, canonical. - Индекс. 30 из этой сотни проверил в поиске. В Яндексе — запросом
url:с точным адресом. В Google — запросомsite:с адресом, потом точным адресом в кавычках, потом запросом с последней частью адреса. «Нет в индексе» — когда страницу не нашёл ни один из запросов. В моём августовском замере на 456 страницах с известным статусом такая проверка совпала с Вебмастером в 100 % случаев, с Search Console — в 99,7 %. - Когда. Один проход 23 октября 2026 года. Это снимок, а не наблюдение: индекс меняется каждый день.
Проверял Вестоход — сервис мониторинга индексации, который я делаю. Та же проверка открыта всем: проверка карты сайта работает без регистрации.
Сколько страниц карты нет в индексе
Карту прочитать удалось у 21 сайта из 26 — что с остальными, ниже. По 30 случайных страниц с каждого:
| Сайты | Сколько | Нет в Яндексе | Нет в Google |
|---|---|---|---|
| интернет-магазины | 5 | 8 из 150 (5 %) | 13 из 150 (9 %) |
| СМИ | 6 | 9 из 180 (5 %) | 19 из 180 (11 %) |
| блоги и площадки с постами | 6 | 36 из 180 (20 %) | 47 из 180 (26 %) |
| сервисы и агрегаторы | 4 | 9 из 120 (8 %) | 36 из 120 (30 %) |
| все | 21 | 62 из 630 (10 %) | 115 из 630 (18 %) |
Большинство сайтов почти целиком в индексе: у типичного Яндекс не нашёл одну страницу из тридцати, Google — две. У пяти сайтов все тридцать есть в обоих поисковиках. Общие 10 и 18 % тянут вверх несколько сайтов: у площадки с пользовательскими постами нет двух третей выборки в обоих поисковиках, у сервиса объявлений — двух третей в Google, у регионального СМИ — 8 страниц из 30 в Яндексе и 12 в Google.
Google знает меньше Яндекса почти везде: у 13 сайтов из 21 он не нашёл больше страниц, у семи — столько же, и только у одного — меньше. Для русскоязычных сайтов это ожидаемо, но разрыв бывает большим: у каталога фильмов в Яндексе все 30 страниц выборки, в Google — 22.
«Нет в индексе» — не всегда ошибка
Карта — приглашение, а не гарантия. Новые страницы ждут обхода. Пользовательские посты, объявления и вакансии поисковик берёт выборочно: их много, они короткие и похожи друг на друга — поэтому у этих групп и самые большие доли. Яндекс называет такие страницы «малоценными или маловостребованными»; как страница с этим статусом дважды выпадала из поиска и возвращалась без правок, я разбирал отдельно. Но если вне индекса заметная часть страниц, ради которых сайт существует, ждать — не стратегия.
Что лежит в самих картах
Вторая часть проверки — что страницы из карты отвечают роботу. Здесь в счёт идут 17 сайтов, где мой робот получил нормальные ответы; о четырёх, где не получил, — в следующем разделе. У десяти из семнадцати в выборке не нашлось ни одной проблемы. Остальные 67 проблемных страниц из 1 700 — на семи сайтах:
| Сайт | Из 100 | Что в карте |
|---|---|---|
| региональное СМИ | 31 | 30 страниц отвечают 404 и 400: материалов нет, а карта их по-прежнему перечисляет. Ни одной из них нет в индексе. Ещё у одной canonical указывает на другой адрес |
| магазин бытовой техники | 14 | 13 страниц закрыты в robots.txt того же сайта: карта зовёт робота туда, куда robots.txt его не пускает. Ещё одна — редирект на раздел |
| IT-сообщество | 12 | адреса без завершающей косой черты: каждый отвечает редиректом 301 на адрес с ней. В индексе — правильный адрес |
| каталог фильмов | 4 | canonical указывает на тот же адрес с параметрами в другом порядке; ещё одна — редирект со старой страницы |
| федеральное СМИ | 3 | canonical статьи указывает на региональный поддомен; ещё одна — редирект из старого раздела |
| онлайн-школа | 2 | одна страница отвечает 404, одна закрыта в robots.txt |
| развлекательная площадка с постами | 1 | noindex |
Мёртвые страницы в карте не вредят индексу — поисковики их уже выкинули. Но читая карту, робот снова и снова получает приглашение на страницы, которых нет, и тратит на них обход. С редиректами то же: в индексе правильный адрес, а робот всякий раз идёт к нему через лишний шаг. Противоречие карты и robots.txt хуже: сайт одновременно говорит «индексируй» и «не заходи», и что из этого выберет поисковик, решает он, а не вы.
Чего почти нет — так это страниц, которые уже сломаны, но ещё в индексе: на весь опрос такая нашлась одна. Сломанные страницы крупных сайтов поисковики, похоже, замечают быстро. На маленьком сайте бывает иначе: в моём эксперименте страница с noindex держалась в поиске Яндекса 27 дней.
Треть сайтов не пустила чужого робота
Девять сайтов из двадцати шести что-то не отдали роботу, который честно назвался своим именем:
- три — два магазина и сервис — ответили отказом 403 уже на карту и robots.txt;
- у сервиса robots.txt объявляет карту, которой нет: по этому адресу 404 для всех, в том числе для запроса, представившегося роботом Яндекса;
- у ещё одного сервиса карты нет ни в robots.txt, ни по стандартному адресу;
- четыре сайта карту отдали, а страницы — нет: магазин электроники ответил 401 на 90 страниц из 100, сервис объявлений — 403 на 99, сайт вакансий — «слишком много запросов» на половину, хотя робот делал не больше двух запросов одновременно, площадка с постами — ошибкой 500 на 79.
Это защита от ботов, и роботов поисковиков она пропускает: у тех, кто отдал карту, страницы в индексе есть. Но любой сторонний инструмент — аудит, проверку индексации, мониторинг — она встретит отказом, а невнимательный инструмент примет отказ за поломку и напишет «сломаны 100 страниц из 100». Если пользуетесь таким сервисом, проверьте, пускает ли его ваша защита, — или смотрите на страницы глазами поисковика: в Вебмастере есть «Проверка ответа сервера», в Search Console — «Проверка URL». Вестоход в таких случаях пишет «сайт не пустил нашего робота» и сломанными такие страницы не считает — этому меня научил как раз этот опрос.
Два подвоха, о которые споткнулся и я
Google метит товарные карточки
В первом подсчёте у одного магазина вышло «нет в Google 30 страниц из 30». Так не бывает, подумал я, и проверил запросы руками. Google находил эти карточки — но отдавал их с хвостом ?srsltid=…: так он метит страницы магазинов, которые есть в его товарной выдаче. Проверка сравнивала адреса вместе с параметрами и говорила «не найдена». На самом деле из тридцати карточек не нашлись две.
Ловушка не только моя: любой инструмент, который буквально сравнивает адрес из выдачи с вашим, у магазина с такой разметкой покажет провал в Google, которого нет. Если ваш сервис проверки индексации вдруг «потерял» весь каталог в Google — посмотрите, нет ли в выдаче этой метки. Вестоход теперь отбрасывает метки отслеживания при сравнении: srsltid, utm_*, gclid, yclid и подобные.
Невидимый символ в начале карты
Две карты — федерального СМИ и того же магазина — начинаются с невидимой метки порядка байтов перед <?xml. Стандарт это допускает, поисковики такие карты читают, а разборщики спотыкаются: мой спотыкался, пока опрос этого не показал. Если какой-то инструмент пишет, что ваша карта «не XML», хотя в браузере она открывается, — посмотрите на первые байты файла.
Что проверить у себя
- Возьмите случайные страницы карты, а не первые, и посмотрите, сколько из них в индексе: в Вебмастере («Страницы в поиске») и в Search Console («Индексирование страниц»). Или проверкой карты — она сделает выборку сама и покажет, сколько это на всю карту.
- Уберите из карты то, что индексироваться не должно: страницы с 404, адреса с редиректом (оставьте конечные), неканонические адреса, страницы, закрытые в robots.txt.
- Проверьте, что карта, которую объявляет robots.txt, существует и отдаётся с кодом 200.
- Если пользуетесь сторонними инструментами, убедитесь, что защита от ботов их пускает, — иначе их «сломанные страницы» рассказывают про защиту, а не про сайт.
Чего эти цифры не говорят
- Тридцать страниц на сайт — грубая оценка для отдельного сайта, поэтому я говорю о группах и о сумме, а не ставлю сайтам баллы. Для общих долей разброс — примерно от 8 до 12 % для Яндекса и от 15 до 22 % для Google, и даже он оптимистичен: страницы одного сайта похожи друг на друга.
- Почти все карты я прочитал не целиком, а первые файлы. Если сайт кладёт в начало карты свежие страницы или, наоборот, старые архивы, выборка смещена в их сторону.
- Четыре группы по 4–6 прочитанных сайтов — это не рынок, а срез. Сравнивать группы между собой стоит осторожно.
- Это один день. Через пару месяцев повторю опрос на тех же сайтах — посмотрим, что изменится.
Вестоход следит за страницами в Яндексе и Google и пишет в Telegram, когда страница сломалась так, что скоро вылетит из индекса, и когда уже вылетела. 30 страниц — бесплатно.
Зарегистрироваться